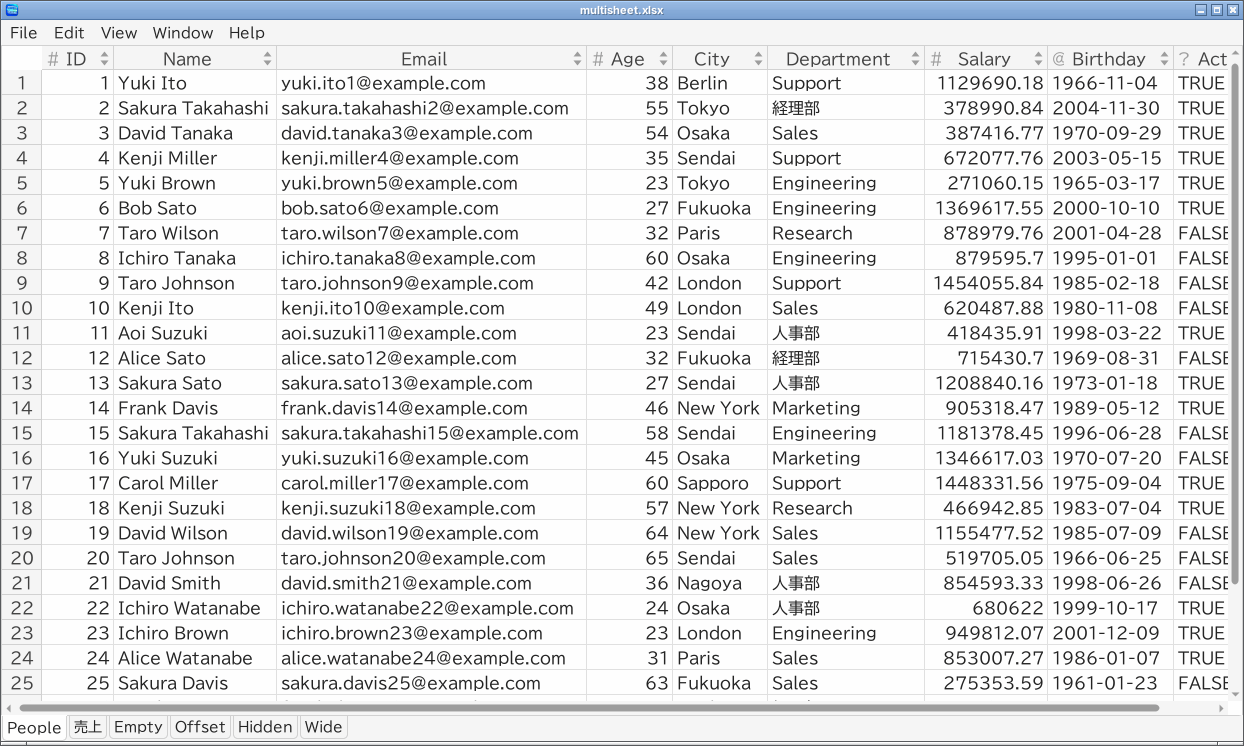
TableSkim はファイル名と先頭のバイト列から形式を判断します。Parquet、DuckDB、SQLite のファイルは先頭のバイト列で判別するため、別の拡張子でも開けます。また、{ や [ で始まるテキストは JSON として読みます。下表の拡張子は一般的なものです。どの形式も同じウィンドウで開きます。複数の表を含む形式では、表ごとに シート(GUI ではウィンドウ下部、ターミナル UI では上部のタブ)として表示します。
| 形式 | 拡張子 | シート |
|---|---|---|
| CSV | .csv | 1 つ |
| TSV | .tsv、.tab | 1 つ |
| VCF | .vcf、.vcf.gz、.vcf.bgz | 1 つ |
| その他のテキスト | .txt、およびテキストに見える未知の拡張子 | 1 つ |
| Excel | .xlsx、.xlsm | ワークシートごと |
| Parquet | .parquet | 1 つ |
| JSON | .json、.ndjson、.jsonl | 1 つ |
| DuckDB | .duckdb、.ddb | テーブル・ビューごと |
| SQLite | .sqlite、.sqlite3、.db、.db3 | テーブル・ビューごと |
.csv ではカンマ、.tsv・.tab・.vcf ではタブです。その他のテキストファイルでは自動判定します。
H)で、そのファイルについて Header(列名)か Data(データ)かを指定することもできます。
gzip(.gz、.bgz)、bzip2(.bz2)、xz(.xz)、 zstd(.zst)で圧縮された CSV / TSV / VCF ファイルは、その場で展開しながら読みます。例:data.csv.gz、variants.vcf.bgz。
CSV / TSV ファイルは UTF-8(BOM の有無を問わず)、UTF-16LE / UTF-16BE(BOM の有無を問わず)、日本語版 Excel が書き出す Shift_JIS(CP932) に対応しています。文字コードはファイルの先頭から自動判定します。判定が誤っているときは、次の方法で切り替えます。
E を押すたびに次の文字コードに切り替わる
--encoding utf-8 | utf-16le | utf-16be | cp932
## 行## で始まる行(VCF のメタ情報行など)は View → Skip lines starting with ##(ターミナル UI では #)で読み飛ばせます。.vcf ファイルでは既定でオンなので、#CHROM ... の行が先頭行になります。
CSV / TSV ファイルには索引がないため、並べ替えやフィルタのために、読み込んだ行をメモリに保持します。その行が約 100 MB、500 MB、1 GB、以降 2 GB ごとのメモリを使うと、読み込みを一時停止して続けるかどうかを尋ねます。
非常に大きなテキストファイルを繰り返し扱う場合は、一度 Parquet か DuckDB に変換しておくことをおすすめします(エクスポートと変換 を参照)。これらの形式では並べ替えやフィルタがデータベース内で行われ、全行を読み込む必要がありません。
.xlsx と .xlsm のブックに対応しています。ワークシートごとに 1 つのシートになります。
Parquet ファイルは DuckDB を通して読みます。並べ替えとフィルタは DuckDB の中で行われるので、どんなに大きなファイルでも使えます。Parquet ファイルに SQL を実行することもできます(SQL の実行 を参照)。
[{...}, {...}])、または 1 行に 1 オブジェクトの形式(NDJSON / JSON Lines、.ndjson、.jsonl)に対応しています。
.json.gz、.jsonl.zst など)も読めます。
{'name': user1, 'tags': [a]} や [1, 2, 3] のように文字列で表示します。
データベースのテーブルとビューを、それぞれシートとして表示します。並べ替えとフィルタはデータベースの中で行われるので、大きなテーブルでも高速です。DuckDB ではテーブルをビューより先に、main スキーマのものを先に並べ、ほかのスキーマのものは スキーマ.テーブル という名前にします。名前が重なった場合(スキーマ a のテーブル b と、main の a.b という名前のテーブル)は、先に並ぶ方をシートとして表示します。もう一方は SQL で参照してください。データベースは読み取り専用で開くので、TableSkim がデータベースを変更することはありません。SQL でクエリすることはできます(SQL の実行 を参照)。
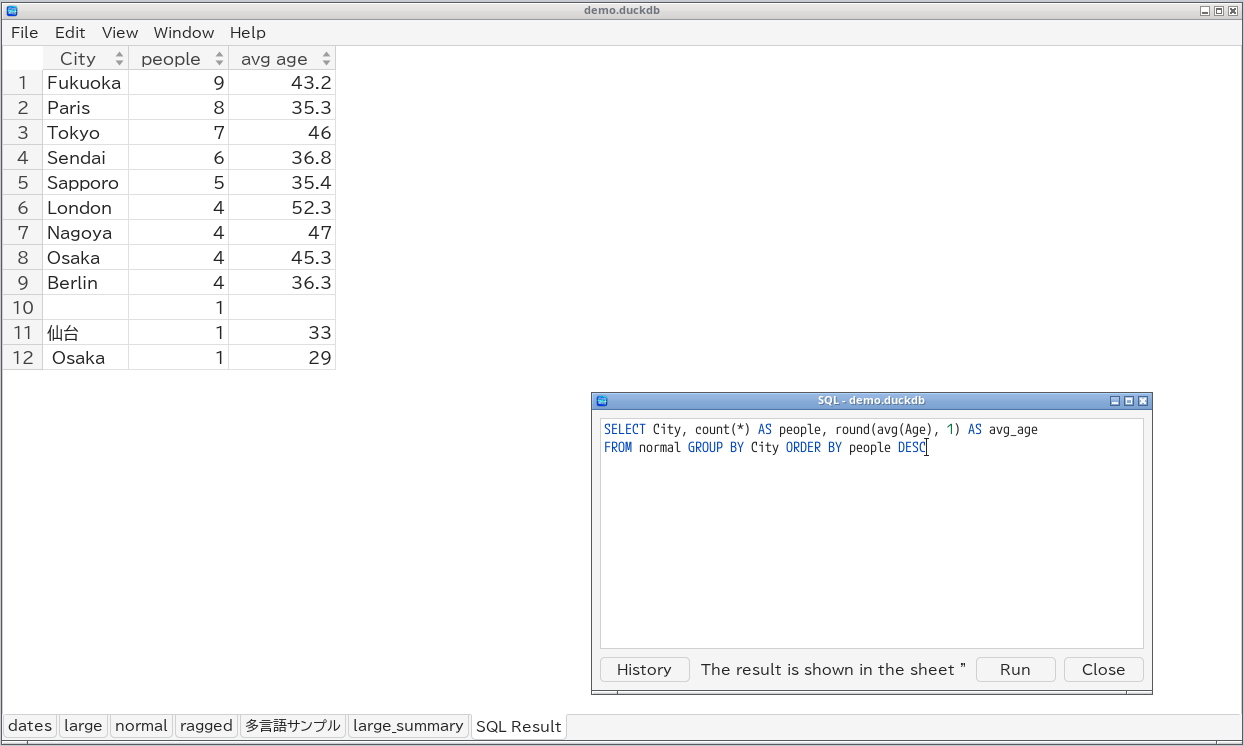
日本語などを含むファイル名、シート名、セルの内容は、どのプラットフォームでも扱えます。